یکی از بزرگترین چالشهای تریدرها در بازارهای مالی، تغییرات ناگهانی و غیرمنتظره رفتار بازار است. بارها دیدهایم استراتژیهایی که ماهها عملکرد درخشانی داشتهاند، ناگهان در یک بازه زمانی، منجر به ضرر و زیان سنگین میشوند. دلیل اصلی این پدیده، تغییر فاز یا اصطلاحا رژیم بازار (Market Regime) تحت تأثیر اخبار اقتصاد کلان، سیاستهای پولی بانکهای مرکزی یا شوکهای هیجانی است.
در این مقاله تخصصی بررسی میکنیم که چگونه میتوان با استفاده از مدل مارکوف پنهان (Hidden Markov Model یا به اختصار HMM) شرایط پرریسک و نوسانی بازار را تشخیص داد و از آن به عنوان یک فیلتر مدیریت ریسک در معاملات الگوریتمی بهره برد.
مدل مارکوف پنهان به زبان ساده و تشخیص وضعیتهای بازار
یکی از دشوارترین مسائل روزمره معاملهگران، این است که رفتار بازارهای مالی بهطور ناگهانی و بدون هشدار تغییر میکند؛ تغییری که میتواند ریشه در سیاستهای پولی و مالی دولتها یا عوامل کلان اقتصادی داشته باشد. به این دورههای متمایز در اصطلاح رژیم بازار (Market Regime) گفته میشود.
مدل پنهان مارکوف (Markov Model) یک مدل ریاضی برای سیستمهایی است که وضعیتهای مختلف دارند و رفتن از یک وضعیت به وضعیت دیگر کاملا محتمل است؛ با این ویژگی که سیستم بدون حافظه است؛ یعنی احتمال رفتن به وضعیت بعدی، تنها به وضعیت فعلی بستگی دارد و تاریخچه گذشته اهمیتی ندارد.
در مدل مارکوف، عوامل تاثیرگذار در تغییر رژیم بازار در دو دسته اصلی طبقهبندی میشوند:
- وضعیتهای پنهان یا نهفته (Hidden / Latent States)
منظور عواملی در بازار است که محرک اصلی تغییرات هستند اما نمیتوان مستقیما آنها را با یک عدد روی نمودار اندازه گرفت.
- مشاهدات (Observations)
مقادیری را شامل میشود که در بازار قابل مشاهده و اندازهگیری مستقیم هستند؛ مانند بازدهی روزانه، قیمتها و حجم معاملات.
مدلهای مارکوف بر اساس میزان کنترل عامل (Agent) و میزان قابل مشاهده بودن اطلاعات به ۴ دسته تقسیم میشوند که در جدول زیر مشاهده میکنید.
| نوع مدل | کاملاً قابل مشاهده (Fully Observable) | تا حدی قابل مشاهده (Partially Observable) |
|---|---|---|
| خودمختار (Autonomous) | زنجیره مارکوف (Markov Chain) | مدل مارکوف پنهان (HMM) |
| کنترلشده (Controlled) | فرآیند تصمیم گیری مارکوف (MDP) | فرآیند تصمیم گیری مارکوف تا حدی مشاهده پذیر (POMDP) |
در بازارهای مالی، فرآیند بازار مستقل از معاملات ما به حیات خود ادامه میدهد و اصطلاحا خودمختار است. همچنین ما به روانشناسی و وضعیت درونی آن دسترسی مستقیم نداریم و فقط بازده قیمتی را میبینیم. از این رو، مدل مارکوف پنهان بهترین چهارچوب برای کشف این حالات در بازارهای مالی است.
مدل ریاضی مارکوف
در این بخش، مدل مارکوف را بر اساس فرمول ریاضی آن معرفی میکنیم. توضیحات این بخش تا حد زیادی تخصصی است و برای درک دقیق آنها نیاز به آشنایی نسبی با مفاهیم علم آمار و ریاضیات وجود دارد.
هر رژیم بازار، میانگین و واریانس (نوسان) بازدهها، همبستگی سریالی و کوواریانس را به شکلی متفاوت رقم میزند و همین ویژگی، کارایی روشهای سری زمانی که بر فرض ایستایی (Stationarity) تکیه دارند را زیر سؤال میبرد. نتیجه عملی آن، پدیدههایی مانند همبستگی پویا، دمهای ضخیم (Fat Tails) و ناهمسانی واریانس (Heteroskedasticity یا خوشه بندی نوسان) است.
راهکار استاندارد برای مواجهه با این مسئله، مدلسازی وضعیتهای بازار است: باید تشخیص دهیم چه زمانی رژیم تازهای آغاز شده و به تناسب آن، استقرار استراتژی، قواعد مدیریت ریسک و حجم پوزیشن را بازتنظیم کنیم. برای این کار، خانوادهای از مدلهای تصادفی فضا-حالت به نام مدل مارکوف (Markov Model) به کار میرود. مدل مارکوف مدلی است که در آن گذارهای تصادفی میان حالتها رخ میدهد و احتمال پرش تنها به حالت کنونی بستگی دارد، نه به حالتهای پیشین. به این ویژگی خاصیت مارکوف گفته میشود.
اگر احتمال گذار مستقل از زمان فرض شود، این گذارها در قالب ماتریس گذار (Transition Matrix) A خلاصه میشوند که درایههای آن چنین تعریف میشود:
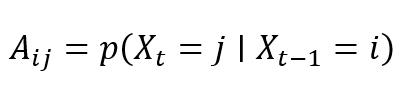
یعنی احتمال اینکه در گام بعد از حالت  به حالت
 برویم. برای یک زنجیره دوحالته، ماتریس گذار به شکل زیر است و سطرهای آن باید جمع یک داشته باشند:
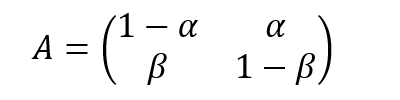
نکتهٔ مهم این است که در یک زنجیره مارکوف (Markov Chain) همه چیز مستقیما قابل مشاهده است؛ یعنی خودمان میبینیم در کدام حالت هستیم. اما در بازار، وضعیت رژیم را هرگز مستقیم نمیبینیم. تنها چیزی که میبینیم، بازدهی قیمتها است. این دقیقا همان جایی است که مدل مارکوف پنهان (Hidden Markov Model یا HMM) وارد میشود.
در HMM، حالتها پنهان یا نهفته (Latent) هستند و مستقیما مشاهده نمیشوند، اما بر مقادیری که قابل مشاهدهاند اثر میگذارند. به این مقادیر قابل مشاهده، مشاهدات (Observations) گفته میشود. در بازار مالی، حالت پنهان همان رژیم بازار است و مشاهدات نیز همان بازدهی دارایی. برای نمونه، بازدهیها تحت تأثیر غیرمستقیم رژیم پنهان قرار دارند و برازش یک HMM روی داده بازدهی، امکان پیشبینی حالت رژیم را فراهم میکند؛ قابلیتی که میتوان از آن بهعنوان فیلتر مدیریت ریسک در معاملات بهره برد.
از نظر ریاضی، توزیع مشترک حالتهای پنهان و مشاهدات به صورت زیر نوشته میشود:
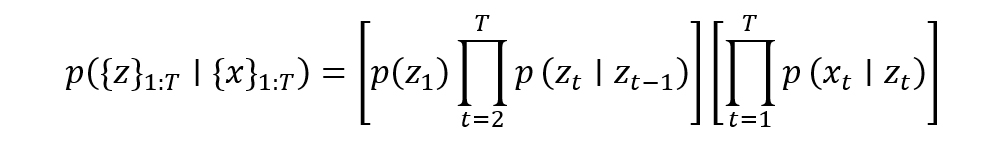
یعنی احتمال دیدن کل حالتها و مشاهدات، برابر است با احتمال خود حالتها ضرب در احتمال مشاهدات با شرط حالتها. منطق این تجزیه ساده است؛ مشاهدات بر حالتها اثر ندارند، اما حالتها بهطور غیرمستقیم بر مشاهدات اثر میگذارند. بخش اول، تابع گذار حالتها و بخش دوم، مدل احتمالی مشاهدات با شرط حالت است.
در بازارهای مالی، برای تشخیص رژیم معمولا تعداد حالتها (K) کوچک انتخاب میشود (اغلب دو یا سه)، چون انتظار نمیرود رژیمها خیلی سریع تغییر کنند و وقتی تغییر کردند، مدتی پایدار میمانند. نکته مهم این است که خاصیت مارکوف برای حالتهای پنهان برقرار است و لزوما برای خود مشاهدات (بازدهیها) صادق نیست؛ چون بازدهیها معمولا خودشان همبستگی سریالی و چگالی غیرگاوسی دارند.
در این مقاله از نسخهٔ گاوسی HMM استفاده میکنیم؛ یعنی توزیع بازدهی در هر حالت، نرمال با میانگین و انحراف معیار مشخص فرض میشود. همین انحراف معیار است که بعدا مبنای تمایز رژیم پرنوسان از رژیم کم نوسان قرار میگیرد.
در ادامه ابتدا استراتژی معاملاتی سادهای میسازیم، سپس لایه تشخیص رژیم را بهعنوان فیلتر مدیریت ریسک روی آن پیاده میکنیم و در پایان کد کامل پیاده سازی در QSTrader را همراه با بک تست و تحلیل نتایج ارائه میدهیم.
استراتژی معاملاتی مبتنی بر میانگین متحرک
استراتژی معاملاتی این مقاله بسیار ساده انتخاب شده است؛ چون هدف اصلی، سنجش لایه مدیریت ریسک است و نه بهینه سازی استراتژی. منطق انتخاب این سادگی آن است که هر تغییری در عملکرد نهایی را میتوان به وضوح به فیلتر رژیم نسبت داد، نه به پیچیدگی پارامترهای سیگنال.
استراتژی از خانواده کلاسیک تقاطع میانگین متحرک (Moving Average Crossover) و در قالب دنبال کننده روند کوتاه مدت است. قوانین آن در هر کندل به این صورت است:
- میانگین متحرک ساده ۱۰ روزه (SMA 10) و ۳۰ روزه (SMA 30) محاسبه میشود.
- اگر میانگین ۱۰ روزه از میانگین ۳۰ روزه بیشتر شود و استراتژی در آن لحظه پوزیشن باز ندارد، پوزیشن خرید (Long) باز میشود.
- اگر میانگین ۳۰ روزه بالاتر از میانگین ۱۰ روزه برود و استراتژی پوزیشن باز دارد، آن پوزیشن بسته میشود.
میانگین متحرک ساده (Simple Moving Average) سادهترین شکل میانگین گیری متحرک است و از میانگین قیمتهای بسته شدن کندلهای n روز اخیر به دست میآید. هرچه دوره زمانی کوتاهتر باشد، واکنش به تغییرات قیمت تندتر است و سیگنالهای نویزی بیشتری تولید میکند؛ هرچه دوره زمانی بلندتر باشد، سیگنال کندتر ولی پایدارتر است. میانگینهای ۱۰ و ۳۰ روزه، انتخاب استاندارد برای ساخت یک سیگنال معاملاتی کوتاه مدت است.
خودِ این استراتژی با این پارامترها روی قیمتهای شاخص S&P 500 چندان کارآمد نیست و در عمل بازده قابل توجهی نسبت به خرید و نگهداری (Buy-and-Hold) صندوق ETF نماد SPY در همان بازه ایجاد نمیکند. این نکته واقعیت مهمی را آشکار میکند که ارزش اصلی نه در سیگنال، بلکه در مدیریت ریسک است.
استراتژیهای دنبال کننده روند در دورههای پرنوسان به شدت ضعیف عمل میکنند؛ چون نوسان بالا سبب میشود روند اشتباه تشخیص داده شده و معاملهای باز شود که بلافاصله با سیگنال معکوس بسته میشود. اگر فیلتر رژیم بتواند دقیقا همین معاملات را حذف کند، کیفیت استراتژی به مراتب بهبود پیدا میکند.
برای اجرای این استراتژی به دادههای روزانهٔ OHLCV (باز، بیشترین، کمترین، بسته و حجم) برای نماد SPY در کل بازه آموزش مدل و بک تست نیاز است. دادهها از Yahoo Finance گرفته میشوند و باید در مسیری قرار گیرند که در فایل تنظیمات QSTrader مشخص شده است. در پیاده سازی اصلی، دادههای آموزش از ۲۹ ژانویه ۱۹۹۳ (نخستین دادهٔ موجود SPY در یاهو) تا ۳۱ دسامبر ۲۰۰۴ و بازه بکتست از ۱ ژانویه ۲۰۰۵ تا ۳۱ دسامبر ۲۰۱۴ انتخاب شده است.
طراحی فیلتر مدیریت ریسک با HMM
ایده کلیدی این است که مدل مارکوف پنهان را طوری آموزش دهیم که بازار را به دو رژیم تفکیک کند:
- رژیم نوسان پایین (Low Volatility Regime): روندها سالم هستند، ریسک هیجانی پایین است و سیگنالهای روند به درستی کار میکنند.
- رژیم نوسان بالا (High Volatility Regime): هیجان بالاست، نوسانات شارپ بدون روند مشخص شکل میگیرند و ریسک دنبال کردن روند بالاست.
منطق فیلتر مدیریت ریسک در این حالت، ساده است. هرگاه استراتژی معاملاتی، سیگنال خرید صادر کند، ابتدا HMM رژیم جاری را بررسی میکند. اگر رژیم بازار نوسان پایین باشد، اجازه ورود به معامله داده میشود. اما اگر مدل تشخیص دهد بازار در رژیم پرنوسان است، سیگنال رد شده و پوزیشنهای باز قبلی به سرعت بسته میشوند.
سازوکار طراحی فیلتر مدیریت ریسک با HMM به صورت زیر است:
- یک مدل HMM گاوسی روی بازدهیهای S&P 500 از ۲۹ ژانویه ۱۹۹۳ تا ۳۱ دسامبر ۲۰۰۴ برازش (Fit) میشود.
- مدل آموزشدیده با فرمت پیکل (Pickle) پایتون سریال سازی و ذخیره میشود تا بعدا بدون نیاز به آموزش مجدد، بارگذاری شود.
- مدل درون یک زیرکلاس از RiskManager در QSTrader فراخوانی میشود.
- برای هر سفارشی که استراتژی میفرستد، سیستم مدیریت ریسک وضعیت جاری را از نظر رژیم نوسان پایین یا نوسان بالا بررسی میکند.
در این طراحی فیلتر، مداخلهگر در سیگنال نیست. یعنی استراتژی همان سیگنال خرید و فروش خودش را میدهد و فیلتر تنها تصمیم میگیرد که آیا آن سیگنال اجازه اجرا شود یا نه. به این ترتیب، منطق استراتژی و منطق ریسک کاملا از هم جدا و مستقل قابل آزمایش باقی میمانند.
پیادهسازی مدل در QSTrader و پایتون
سه ابزار اصلی برای پیادهسازی مدل مارکوف پنهان عبارتاند از:
- QSTrader: چارچوب متن باز بک تست به زبان پایتون که بهجای ساخت موتور معاملاتی از صفر، از ماژولهای آمادهٔ آن برای مدلسازی قیمت، استراتژی، مدیریت ریسک و قیف معاملات استفاده میکنیم.
- hmmlearn: کتابخانه پایتونی که پیادهسازی آماده HMM (از جمله نسخه گاوسی) را فراهم میکند و از API کتابخانه Scikit-Learn الهام گرفته است. بهجای پیادهسازی الگوریتمهای فیلترینگ و یادگیری از پایه، مستقیما از این کتابخانه استفاده میکنیم.
- NumPy و Pandas: برای دستکاری سریهای زمانی، ماتریسها و دادههای CSV.
منطق کلی این پروژه در چهار فایل جداگانه زیر سازماندهی شده است که به راحتی قابل اجرا و آزمایش است.
| فایل | نقش |
|---|---|
| regime_hmm_train.py | برازش مدل HMM گاوسی روی بازدهیهای S&P 500 و ذخیره مدل |
| strategy.py | منطق استراتژی دنبال کننده روند مبتنی بر تقاطع میانگین متحرک |
| regime_hmm_risk_manager.py | منطق فیلتر رژیم در قالب زیرکلاس RiskManager |
| regime_hmm_backtest.py | اتصال ماژولها به هم و اجرای بک تست |
جداسازی منطق آموزش، استراتژی، مدیریت ریسک و اجرای بک تست از هم، یک انتخاب طراحی آگاهانه است. به این ترتیب هر ماژول را میتوان مستقلا آزمایش کرد و بعدا یک لایه ریسک دیگر را بدون تغییر استراتژی، جایگزین کرد. این دقیقا همان الگویی است که QSTrader برای معماری خود در نظر گرفته است.
برای نصب پیشنیازها کافی است دستور زیر را اجرا کنید:
pip install qstrader hmmlearn pandas numpy matplotlib seaborn
آموزش مدل Hidden Markov Model
ابتدا کتابخانههای لازم را فراخوانی میکنیم:
# regime_hmm_train.py
from __future__ import print_function
import datetime
import pickle
import warnings
from hmmlearn.hmm import GaussianHMM
from matplotlib import cm, pyplot as plt
from matplotlib.dates import YearLocator, MonthLocator
import numpy as np
import pandas as pd
import seaborn as sns
وظیفه هر یک از بخشهای فراخوان شده به شرح زیر است:
- pickle: سریال سازی مدل آموزش دیده و ذخیره آن روی دیسک تا بعدا در RiskManager بارگذاری شود.
- warnings: خاموشکردن هشدارهای منسوخ شده (Deprecation) که در نسخههای جدید Scikit-Learn تولید میشوند و خروجی کنسول را شلوغ میکنند.
- GaussianHMM: کلاس اصلی مدل، که توزیع مشاهدات در هر حالت را نرمال (گاوسی) فرض میکند.
- matplotlib و seaborn: برای رسم نمودارهای تشخیصی که به ما کمک میکنند رفتار مدل را با چشم خود بررسی کنیم.
سپس تابعی مینویسیم که داده CSV را از Yahoo Finance بخواند، به بازه آموزش محدود کند و بازدهی (Percentage Return) قیمت پایانی تعدیل شده را محاسبه نماید:
“””
Obtain the prices DataFrame from the CSV file,
filter by the end date and calculate the
percentage returns.
“””
df = pd.read_csv(
csv_filepath, header=0,
names=[
“Date”, “Open”, “High”, “Low”,
“Close”, “Volume”, “Adj Close”
],
index_col=”Date”, parse_dates=True
)
df[“Returns”] = df[“Adj Close”].pct_change()
df = df[:end_date.strftime(“%Y-%m-%d”)]
df.dropna(inplace=True)
return df
پیش از آموزش، بهتر است امکان بصری سازی حالتهای پنهان را نیز فراهم کنیم تا مطمئن شویم مدل رفتار عقلانی دارد. تابع plot_in_sample_hidden_states دقیقا همین کار را میکند و از فایل راهنمای خود hmmlearn اقتباس شده است:
def plot_in_sample_hidden_states(hmm_model, df):
“””
Plot the adjusted closing prices masked by
the in-sample hidden states as a mechanism
to understand the market regimes.
“””
# Predict the hidden states array
hidden_states = hmm_model.predict(df[“Returns”].values.reshape(-1, 1))
# Create the correctly formatted plot
fig, axs = plt.subplots(
hmm_model.n_components,
sharex=True, sharey=True
)
colours = cm.rainbow(
np.linspace(0, 1, hmm_model.n_components)
)
for i, (ax, colour) in enumerate(zip(axs, colours)):
mask = hidden_states == i
ax.plot_date(
df.index[mask],
df[“Adj Close”][mask],
“.”, linestyle=’none’,
c=colour
)
ax.set_title(“Hidden State #%s” % i)
ax.xaxis.set_major_locator(YearLocator())
ax.xaxis.set_minor_locator(MonthLocator())
ax.grid(True)
plt.show()
این تابع تعداد زیرنمودارها را با تعداد حالتهای پنهان هم اندازه میکند و روی هرکدام، فقط نقاطی از قیمت را رسم میکند که مدل در آن روزها همان حالت را پیشبینی کرده است. نتیجه در اجرای اصلی این است که مدل، دورههای رونددار و پرنوسان را به خوبی از هم جدا میکند و به ویژه بخش عمده سال ۲۰۰۸ (بحران مالی) در حالت شماره ۱ قرار میگیرد و نشان میدهد مدل واقعا اطلاعات معناداری استخراج کرده است.
سرانجام، همهچیز در تابع اصلی پروژه به هم وصل میشود:
if __name__ == “__main__”:
# Supress warning messages
warnings.filterwarnings(“ignore”)
csv_filepath = “SPY.csv”
pickle_path = “hmm_model_spy.pkl”
# Load the data and split the train and test sets
end_train_date = datetime.datetime(2004, 12, 31)
df = obtain_prices_df(csv_filepath, end_train_date)
# Create the returns matrix for hmmlearn
# (univariate model, but hmmlearn expects 2D array)
rets = np.column_stack([df[“Returns”]])
# Create the Hidden Markov Model (Gaussian)
# with 2 hidden states and fit it to the returns
hmm_model = GaussianHMM(n_components=2, covariance_type=”full”, min_covar=1e-3, n_iter=1000)
hmm_model.fit(rets)
# Output the states and transition matrix
print(“Model score:”, hmm_model.score(rets))
print(“Transition matrix:”)
print(hmm_model.transmat_)
print(“Means and variances of each state:”)
print(hmm_model.means_)
print(hmm_model.covars_)
# Plot the in-sample hidden states
plot_in_sample_hidden_states(hmm_model, df)
# Pickle the model to the file
with open(pickle_path, “wb”) as f:
pickle.dump(hmm_model, f)
در پایان، مدل را با pickle ذخیره میکنیم تا در لایه ریسک بارگذاری شود. برای بازخوانی مدل در فایلهای بعدی کافی است بنویسیم:
import pickle
with open(“hmm_model_spy.pkl”, “rb”) as f:
hmm_model = pickle.load(f)
اجرای بک تست و بررسی نتایج
فایل regime_hmm_backtest.py وظیفه دارد همهٔ ماژولهای قبلی را به هم وصل کند و یک بک تست کامل اجرا نماید. برخلاف کدهای آموزش و ریسک که مرورشان در بخشهای پیشین انجام شد، در این بخش فقط به منطق اتصال و پارامترهای کلیدی میپردازیم.
طرح کلی بکتست به این صورت است:
- دوره آموزش مدل: از ۲۹ ژانویه ۱۹۹۳ تا ۳۱ دسامبر ۲۰۰۴.
- دوره بک تست: از ۱ ژانویه ۲۰۰۵ تا ۳۱ دسامبر ۲۰۱۴.
- داده ورودی: بازدهیهای روزانه SPY که از فایل CSV خوانده میشود.
- استراتژی: تقاطع میانگین متحرک ۱۰ و ۳۰ روزه.
- مدیر ریسک: زیرکلاس RegimeHMMRiskManager که مدل HMM را بارگذاری و وضعیت جاری را برمیگرداند.
- قیف معاملات: مدیریت هزینهها و اجرا.
بک تست روی دادههای خارج از نمونه (Out-of-Sample) اجرا میشود و مدل در طول مسیر دوباره آموزش نمیبیند. این بدان معناست که HMM فقط با اطلاعاتی که تا سال ۲۰۰۴ داشته، وضعیتهای ۲۰۰۵ به بعد را پیشبینی میکند و نتیجه بههیچوجه نمیتواند محصول نادیده گرفتن آینده یا بیش برازش (Overfitting) باشد.
در اصلیترین بخش کد، باید چهار مؤلفه اصلی QSTrader را با تنظیمات پروژه مقداردهی کنیم:
if __name__ == “__main__”:
# HMM model to use (loaded from pickle)
pickle_path = “hmm_model_spy.pkl”
# CSV data file for SPY (Yahoo Finance format)
csv_dir = “PATH/TO/YOUR/DATA”
ticker = “SPY”
# Set up the backtest parameters
initial_equity = 500000.00
start_date = datetime.datetime(2005, 1, 1)
end_date = datetime.datetime(2014, 12, 31)
# Use the YahooDailyCsvBarPriceHandler with
# calc_adj_returns=True to also store returns
price_handler = YahooDailyCsvBarPriceHandler(
csv_dir, events_queue, tickers,
calc_adj_returns=True
)
# Use the regime HMM risk manager overlay
risk_manager = RegimeHMMRiskManager(pickle_path)
# Backtest object tying everything together
backtest = TradingSession(
events_queue,
strategy,
tickers,
initial_equity,
start_date,
end_date,
price_handler=price_handler,
risk_manager=risk_manager
)
performance = backtest.run()
فلگ calc_adj_returns=True حتما فعال شود؛ چون RegimeHMMRiskManager برای پیشبینی رژیم، به فهرست بازدهیهای ذخیره شده در PriceHandler دسترسی دارد و اگر این فلگ فعال نباشد، مدل همیشه حالت پیشفرض (بدون بازدهی) را برمیگرداند.
نتایج بک تست که فیلتر رژیم HMM نسبت شارپ (Sharpe Ratio) استراتژی را بهبود میدهد و به ویژه در دوره بحران مالی ۲۰۰۸، از وقوع زیانهای بزرگ جلوگیری میکند.
تحلیل عملکرد و محدودیتهای مدل
پس از مشاهده نتایج بک تست، لازم است صادقانه به این پرسش پاسخ دهیم که فیلتر رژیم HMM در عمل چقدر به ما کمک میکند و کجای کار کماکان پرریسک است. نکته مهم آن است که مثل هر ابزار آماری دیگری، HMM هم یک نسخه جادویی نیست و محدودیتهای خاص خودش را دارد که در ادامه بررسی میکنیم:
- انتخاب تعداد حالتها (K)
در این پروژه دو حالت در نظر گرفته شد که ساده است و تفسیرپذیری بالایی دارد، اما انتخاب درست K همیشه سؤال برانگیز است. افزایش تعداد حالتها همیشه به معنی بهبود نیست و میتواند پیچیدگی کار را افزایش دهد.
- فرض گاوسی بودن
در مدل GaussianHMM فرض میشود که بازدهیها در هر حالت، توزیع نرمال دارند؛ در حالی که دادههای مالی واقعی همواره این گزارش را تأیید نمیکنند. یعنی رخدادهای غیرمنتظره (مانند سقوط بازار ۲۰۰۸) بیشتر از حد انتظار نرمال رخ میدهند. همین امر میتواند سبب شود مدل در بحبوحه بحران، تغییر رژیم را با تأخیر تشخیص دهد.
- تفاوت تشخیص حالت یا دستیابی به سود
یکی از اشتباهات رایج آن است که فکر کنیم تشخیص حالت، مستقیم به سوددهی منجر میشود. مدل تنها حالت را شناسایی میکند و تصمیم نهایی در خصوص ورود به معامله بر عهده تریدر است. یعنی اگر قاعده عدم معامله در بازار پرنوسان بهدرستی طراحی نشده باشد، حتی با تشخیص درست حالت، معاملات اشتباه انجام میشود.
- پایداری پارامترها در طول زمان
پارامترهای HMM، احتمالهای گذار و میانگینها در طول زمان میتوانند تغییر کنند. به همین دلیل، مدلسازی در عمل به چرخههای دورهای بازآموزی (Retraining) نیاز دارد.
کلام پایانی
بهکارگیری مدل مارکوف پنهان در معاملات الگوریتمی نشان میدهد که مدیریت ریسک سیستماتیک چه نقش حیاتی در بقا و موفقیت تریدر ایفا میکند. استراتژیهای سادهای چون تقاطع میانگین متحرک بهتنهایی عملکرد چندان چشمگیری در برابر استراتژی خرید و نگهداری ندارند؛ اما هنگامی که با یک لایه تشخیصی هوشمند نظیر HMM ترکیب میشوند، از تله معامله در شرایط پرریسک در امان میمانند. درک ماهیت رژیمهای پنهان بازار و تبدیل آنها به یک کلید قطع کننده اضطراری (Circuit Breaker) برای رباتهای معاملاتی، یکی از ابزارهای قدرتمند در کنترل سود و زیان پرتفوی است.
سوالات متداول
کاربرد مدل مارکوف پنهان در معاملهگری چیست؟
با استفاده از مدل مارکوف پنهان میتوان به سازوکاری ریاضیاتی برای تشخیص زمان تغییر روندهای صعودی و نزولی بازار با دقت مناسب دست پیدا کرد.
آیا مدل مارکوف پنهان همواره در تشخیص زمان تغییر رژیم بازار درست عمل میکند؟
خیر، مدل ریاضی مارکوف پنهان بر اساس پیش فرضها و محدودیتهایی شکل گرفته که باعث میشود همواره نتایج دقیق به دنبال نداشته باشد.


نظرات کاربران